خطای OOM در لینوکس را با گزارش زمان توقف پردازش تشخیص دهید، نه فقط عدد RAM آزاد پس از رخداد. پیام Killed، خروجی 137 یا توقف ناگهانی سرویس میتواند سرنخ باشد، اما بهتنهایی کمبود حافظه را ثابت نمیکند. ابتدا لاگ kernel، سرویس و در صورت وجود محدودیت container یا cgroup را کنار هم ببینید؛ سپس مصرف و همزمانی کارها را اصلاح کنید.
این راهنما برای مدیر VPS یا سرور لینوکسی است که برنامه، دیتابیس یا پردازش PHP آن ناگهان متوقف میشود. دستورهای نمونه عمدتاً برای مشاهدهاند و روی سیستم دارای systemd نوشته شدهاند. نام سرویس و بازه زمانی را با محیط واقعی جایگزین کنید. قرار نیست برای یک خطای نامشخص، حفاظت حافظه را خاموش کنیم یا همه پردازشها را متوقف کنیم.
OOM Killer چیست و چرا سرویس بعد از آن دوباره کار میکند؟
وقتی تخصیص حافظه در محدودهای به مشکل میرسد، سیستم ممکن است پردازشی را برای آزادشدن منابع خاتمه دهد. در لینوکس، رخداد میتواند در سطح کل سیستم یا در یک cgroup محدود اتفاق بیفتد. علاوه بر سازوکار kernel، بعضی توزیعها از systemd-oomd برای واکنش به فشار حافظه استفاده میکنند. پس نبود یک عبارت در لاگ kernel همه حالتها را رد نمیکند.
بعد از خاتمه پردازش، حافظه آزاد میشود و مدیر سرویس شاید برنامه را دوباره راهاندازی کند. به همین دلیل، دیدن free مناسب چند دقیقه بعد، وضعیت لحظه اختلال را نشان نمیدهد. اگر فقط زمان فعلی را اندازه بگیرید، ممکن است یک مشکل تکرارشونده را طبیعی تصور کنید. زمان دقیق و سابقه مصرف، مهمترین دادههای شروع هستند.
| نشانه | چه چیزی را بررسی کنیم؟ | نتیجهای که نباید عجولانه بگیریم |
|---|---|---|
| عبارت Killed در ترمینال | لاگ همان دقیقه و نوع سیگنال | هر Killed الزاماً OOM نیست |
| خروج با کد 137 | دلیل SIGKILL و وضعیت runtime | کد خروج بهتنهایی علت را مشخص نمیکند |
| حافظه میزبان آزاد، container متوقف | محدودیت cgroup یا container | RAM آزاد میزبان محدودیت محلی را رد نمیکند |
| توقف در زمان بکاپ | همزمانی، مصرف و تنظیمات کار | خرید RAM قبل از شناخت الگو تنها گزینه نیست |
| رشد تدریجی حافظه برنامه | نشت حافظه، کش و تعداد workerها | restart مکرر، علت را درمان نمیکند |
۱. ساعت رخداد و پردازش متوقفشده را پیدا کنید
از گزارش مانیتورینگ، خطای برنامه یا زمان اعلام کاربر، یک بازه محدود بسازید. در سیستم دارای journal، لاگ kernel و سرویس را بخوانید. نام app.service در مثال فرضی است. اگر نام واقعی را نمیدانید، از مستندات نصب یا فهرست واحدهای سیستم کمک بگیرید؛ حدسزدن نام سرویس میتواند به بررسی گزارش نامرتبط منجر شود.
sudo journalctl -k --since "1 hour ago"
sudo journalctl -u app.service --since "1 hour ago"
systemctl status app.service --no-pager
به عبارتهای Out of memory، Killed process و نام پردازش توجه کنید و PID، زمان و محدوده رخداد را ثبت کنید. اگر سیستم از زمان خطا reboot شده، نگهداری journal و بازه بوت قبلی اهمیت دارد؛ نبود داده قدیمی ممکن است از سیاست ذخیرهسازی لاگ باشد. متن کامل لازم را نگه دارید و پیش از اشتراکگذاری، دادههای حساس برنامه را بپوشانید.
اگر systemd-oomd در توزیع شما فعال است، گزارش آن را نیز بررسی کنید. این سرویس میتواند بر اساس فشار حافظه و پیکربندی cgroup عمل کند. همه سرورها آن را ندارند؛ پیام «واحد پیدا نشد» به معنی نیاز به نصب فوری آن برای رفع خطای فعلی نیست. ابتدا ابزار و معماری موجود را بشناسید.
sudo journalctl -u systemd-oomd --since "1 hour ago"۲. وضعیت فعلی را ثبت کنید، اما آن را با گذشته یکی ندانید
حافظه و swap را ببینید و پردازشهای پرمصرف فعلی را پیدا کنید. این دادهها برای بازسازی وضعیت بعد از رخداد مفیدند. در free، ستون available برای تخمین حافظه قابل استفاده از مقدار free خام کاربردیتر است؛ وجود cache بهخودیخود نشانه هدررفتن RAM نیست. همچنین واحدهای خروجی فرمانها را با هم اشتباه نگیرید.
free -h
ps -eo pid,comm,rss --sort=-rss | head -n 11
vmstat 1 5
RSS تصویر کاملی از همه انواع حافظه و اشتراک صفحات نیست؛ جمع ساده آن برای همه پردازشها همیشه مصرف واقعی میزبان را نمیدهد. در vmstat هم فشار جابهجایی حافظه را در کنار تأخیر و بار کاری بخوانید. یک نمونه کوتاه برای تصمیم ارتقای دائمی کافی نیست. اگر مشکل در ساعت مشخص تکرار میشود، همان بازه را با پایش ثبت کنید.
۳. محدودیت حافظه سرویس یا container را جدا بررسی کنید
ممکن است VPS ظرفیت کافی داشته باشد ولی برنامه زیر MemoryMax محدودتری اجرا شود. برای سرویس systemd، مقدارهای اعمالشده را بخوانید. تنظیمات ارثرسیده از slice و والدها نیز میتواند مؤثر باشد. تغییر فایل برنامه بدون بررسی محدودیت بالادستی، شاید نتیجهای نداشته باشد. در container نیز از گزارش runtime همان محیط استفاده کنید.
systemctl show app.service -p MemoryCurrent -p MemoryMax -p OOMPolicyدر محیط cgroup v2، شمارندههایی مانند memory.events به تشخیص رخدادهای همان گروه کمک میکنند، اما مسیر و تفسیر آن به چیدمان سیستم وابسته است. یک مسیر ثابت از اینترنت را روی همه containerها کپی نکنید. از شناسه سرویس و اطلاعات runtime به cgroup درست برسید و زمان تغییر شمارنده را با توقف برنامه تطبیق دهید.
۴. تعداد کارهای همزمان را قبل از افزایش سقفها بررسی کنید
یک برنامه با تعداد زیادی worker میتواند مجموع حافظه بزرگی مصرف کند، حتی وقتی هر worker بهتنهایی غیرعادی نیست. زمان بکاپ، پردازش تصویر، build و درونریزی را کنار هم بگذارید. اگر همه در یک بازه اجرا میشوند، جداکردن زمان آنها یا محدودکردن concurrency میتواند فشار اوج را کاهش دهد. انتخاب مقدار مناسب به اندازهگیری همان بار کاری نیاز دارد.
برای نمونه، اگر هر worker بهطور تقریبی حافظهای مصرف میکند، علاوه بر تعداد workerها، سهم دیتابیس، سیستمعامل و حاشیه کارهای ناگهانی را در نظر بگیرید. این محاسبه برآورد شروع است، نه تضمین ظرفیت. افزایش همزمان memory_limit در PHP و تعداد workerها میتواند سقف مجموع مصرف را بالاتر ببرد؛ دو تنظیم مستقل را بدون محاسبه تغییر ندهید.
۵. رشد حافظه و نشت احتمالی را از فشار موقت جدا کنید
اگر مصرف پس از هر بار پردازش بالا میرود و برنمیگردد، نمودار روند و نوع درخواستها را جمع کنید. ممکن است کش برنامه، ورودی بزرگ یا نشت حافظه مطرح باشد. نمودار رشد بهتنهایی نشت را ثابت نمیکند؛ باید با چرخه عمر برنامه و رفتار مورد انتظار مقایسه شود. نسخه مؤلفهها و تغییر اخیر را ثبت و در محیط آزمایشی بازتولید کنید.
اگر فقط یک عملیات مشخص مانند واردکردن فایل بزرگ مشکل میسازد، همان کار را به بخشهای کوچکتر و قابل بازیابی تقسیم کنید یا از روش رسمی پردازش پسزمینه برنامه استفاده کنید. restart میتواند دسترسی را موقتاً برگرداند، اما سابقه اندازهگیری را قبل از آن نگه دارید. راهاندازی خودکار بیوقفه نیز ممکن است حلقه خطا و فشار بیشتری ایجاد کند.
آیا افزودن Swap یا ارتقای RAM راهحل است؟
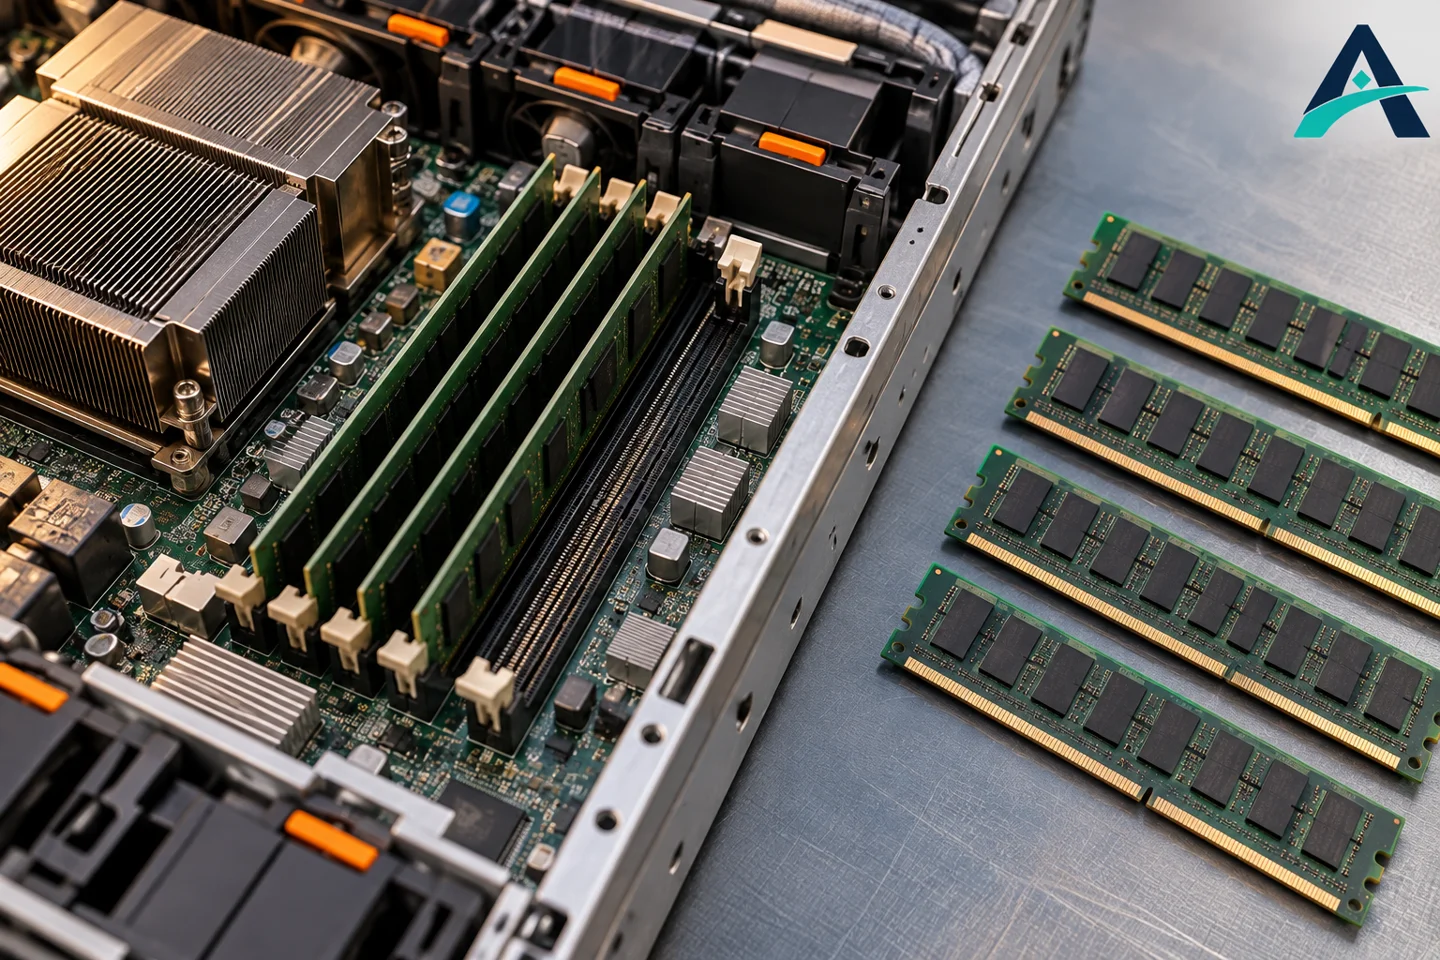
Swap میتواند برای برخی الگوها حاشیه واکنش ایجاد کند، ولی جای RAM و اصلاح مصرف بیرویه نیست. اتکای سنگین به دیسک میتواند تأخیر سرویس را بالا ببرد. نوع بار کاری، فضای دیسک، سیاست میزبان و محدودیت container را بررسی کنید. ساختن فایل swap با اندازه ثابت برای همه سرورها، توصیه دقیقی نیست؛ مقاله راهنماهای منابع سرور در مجله آفاق هاست را نیز بر اساس موضوع RAM و Swap دنبال کنید.
ارتقا وقتی منطقیتر است که مصرف مورد انتظار و فشار اوج ثبت شده باشد و تنظیم منابع با نیاز برنامه هماهنگ باشد. خاموشکردن OOM Killer، محافظتکردن تصادفی همه پردازشها یا حذف محدودیتها بدون ظرفیت کافی میتواند کل میزبان را بیپاسخ کند. ابتدا دامنه مصرف را اصلاح کنید، سپس افزایش ظرفیت را با آزمون بار واقعی ارزیابی کنید.
پس از تغییر، چه چیزی را دوباره بسنجیم؟
همان عملیات مشکلدار را در زمان و محیط مناسب تکرار کنید و حافظه اوج، زمان پاسخ و تعداد رخدادهای خاتمه را ببینید. فقط فعالبودن سرویس کافی نیست. اگر محدودیت یا concurrency تغییر کرده، اثر آن روی صف و تأخیر را هم بررسی کنید. ممکن است توقف رفع شود ولی زمان پردازش بسیار بالا برود؛ هدف، رفتار پایدار در نیاز واقعی شماست.
برای پشتیبانی، زمان، نام سرویس، بخش مرتبط لاگ، مشخصات محدودیت و نتیجه تغییر را بفرستید. سرور مجازی ایران را بر اساس منابع اندازهگیریشده انتخاب کنید و برای تحلیل تکرار خطا از مدیریت سرور آفاق هاست کمک بگیرید. بدون داده، نمیتوان گفت صرفاً یک پلن بزرگتر مشکل را برای همیشه برطرف میکند.
پرسشهای رایج
آیا کد خروج 137 حتماً OOM است؟
خیر. این کد معمولاً با SIGKILL مرتبط است، اما علت ارسال سیگنال باید از kernel، مدیر سرویس یا runtime مشخص شود.
چرا بعد از توقف برنامه، حافظه آزاد زیاد است؟
خاتمه پردازش حافظه را آزاد میکند. وضعیت پس از رخداد را با نمودار و لاگ لحظه اختلال مقایسه کنید.
اگر میزبان RAM آزاد دارد، چرا container متوقف میشود؟
محدودیت محلی container یا cgroup میتواند زودتر از ظرفیت کل میزبان اعمال شود. سقف واقعی همان محیط را بررسی کنید.
منابع رسمی
سرویسهای مرتبط با این مطلب
برای بررسی راهکار مناسب، مشخصات و شرایط این خدمات را ببینید.
پرسشها و دیدگاههای شما
سؤال یا تجربه مرتبط با این مطلب دارید؟ با ما و خوانندگان مجله آفاق هاست در میان بگذارید.