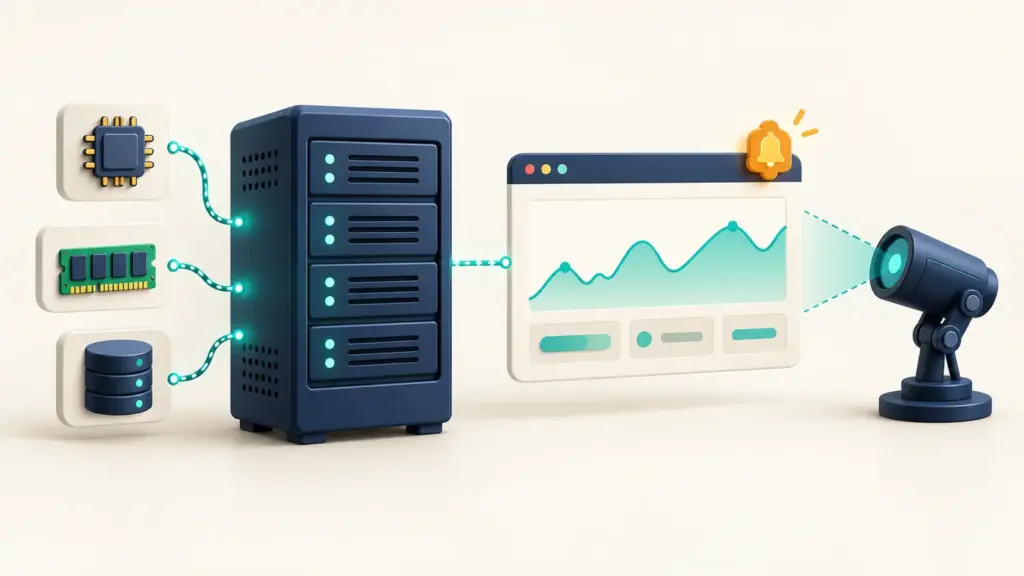
مانیتورینگ سرور فقط نمایش نمودار CPU و RAM نیست. سیستم پایش باید کمک کند بفهمید کاربر میتواند عملیات اصلی را انجام دهد یا نه، چه نشانهای از اختلال وجود دارد و چه کسی باید پیگیری کند. اگر هشدار تولید میشود ولی کسی مسئول رسیدگی نیست، ابزار پایش بهتنهایی پایداری سرویس ایجاد نمیکند.
برای یک سایت شرکتی، فروشگاه یا برنامه سازمانی، نقطه شروع مناسب ترکیب پایش بیرونی و اطلاعات داخل سرور است. در این راهنما، هفت موضوع قابل پایش، نمونه اولویتبندی و مسیر آزمون هشدار را مرور میکنیم. آستانههای هر پروژه باید با مصرف عادی و حساسیت عملیات تنظیم شوند؛ یک عدد ثابت برای تمام سرویسها مناسب نیست.
تفاوت مانیتورینگ سرور و مانیتورینگ سایت
پایش سرور وضعیت منابع و سرویسهای زیرساخت را نشان میدهد؛ برای مثال مصرف حافظه، ظرفیت دیسک یا فعال بودن پایگاه داده. پایش سایت از بیرون بررسی میکند آیا پاسخ مورد انتظار دریافت میشود. ممکن است سرور روشن باشد و وبسرور پاسخ بدهد، اما فرم ورود یا جستوجوی محصول کار نکند. در این حالت، تست زنده بودن دستگاه برای تشخیص مسئله کافی نیست.
از سوی دیگر، مشاهده خطای سایت علت را روشن نمیکند. برای تشخیص ممکن است به زمان اجرای PHP، وضعیت دیتابیس و گزارش شبکه نیاز داشته باشید. ترکیب این دو نگاه، دامنه بررسی را کوچکتر میکند. ابزار بررسی سلامت سایت آفاق هاست برای مشاهده برخی شاخصهای دامنه، DNS، وب و ایمیل مفید است؛ پایش پیوسته منابع و عملیات داخلی، طراحی جداگانه میخواهد.
ابتدا نتیجهای را که برای کاربر مهم است تعریف کنید
برای فروشگاه، فقط باز شدن صفحه خانه کافی نیست. مشاهده محصول، افزودن به سبد و ورود به مسیر پرداخت اهمیت دارند. برای سامانه سازمانی، ورود و دریافت اطلاعات ممکن است عملیات اصلی باشد. فهرست کوتاهی از این مسیرها بسازید و مشخص کنید هر آزمون باید چه پاسخی دریافت کند. کد 200 همراه با صفحه خطای برنامه، نتیجه موفق واقعی نیست.
در راهنمای مانیتورینگ Google SRE، زمان پاسخ، ترافیک، خطا و اشباع منابع بهعنوان چهار سیگنال مهم معرفی میشوند. از این چارچوب میتوان برای چیدن داشبورد استفاده کرد: تقاضا چقدر است، پاسخ چقدر طول میکشد، چه سهمی شکست میخورد و کدام منبع به محدودیت نزدیک میشود. این معیارها باید در کنار اثر واقعی بر کاربر تفسیر شوند.
جدول پایشهای مهم و مسیر رسیدگی
| موضوع | چه چیزی سنجیده شود؟ | نمونه اقدام بعد از هشدار |
|---|---|---|
| دسترسپذیری | پاسخ معتبر از مسیر مهم سایت | مقایسه نقاط بیرونی و بررسی مبدأ |
| زمان پاسخ | روند تأخیر درخواست موفق و عملیات اصلی | مقایسه برنامه، دیتابیس و شبکه |
| خطاها | نسبت خطا و نوع عملیات درگیر | تطبیق با لاگ و آخرین تغییر |
| CPU و حافظه | فشار پایدار و نشانههای کمبود ظرفیت | شناسایی فرآیند و الگوی بار |
| دیسک | فضای آزاد، inode و سرعت رشد | پیدا کردن شاخه تولیدکننده داده |
| دامنه و SSL | اعتبار، تمدید و پاسخ دامنه صحیح | پیگیری تمدید و کنترل نصب گواهی |
| بکاپ و جمعآوری داده | تازگی نتیجه موفق و سلامت مسیر پایش | بررسی اجرای کار و آزمون بازیابی |
۱. دسترسپذیری را از بیرون شبکه بسنجید
اگر فقط از همان دستگاه وضعیت سایت را بررسی کنید، ممکن است اختلال مسیر عمومی دیده نشود. یک نقطه بیرونی مستقل، بخشی از این فاصله را پوشش میدهد. برای سایتی با کاربران در چند شبکه، نتایج چند مبدأ کمک میکند قطعی گسترده را از اختلال مسیر مشخص جدا کنید. البته اختلاف یک نتیجه بهتنهایی علت را ثابت نمیکند.
دوره بررسی را با اهمیت سرویس انتخاب کنید. فاصله نمونهبرداری، تعداد تکرار لازم برای اعلام مشکل و زمان ارسال اعلان، همگی بر زمان کشف اثر دارند. اگر فقط هر چند دقیقه آزمون دارید، نمیتوانید ادعا کنید تمام قطعیهای چندثانیهای ثبت شدهاند. تعریف گزارش دسترسپذیری باید این محدودیت را روشن کند.
۲. زمان پاسخ را با زمینه عملیات بخوانید
میانگین میتواند درخواستهای کند را پنهان کند. اگر ابزار داده کافی جمع میکند، صدکهایی مانند p95 را هم ببینید و روش محاسبه را بشناسید. صدک ۹۵ بهطور ساده مرزی است که بخش بزرگی از نمونهها زیر آن قرار میگیرند؛ در مجموعه بسیار کوچک، نتیجه ممکن است برای تصمیم پایدار کافی نباشد.
زمان پاسخ صفحه کششده را با صفحه پویا یا عملیات پردازشی یکسان نگیرید. برای مثال فرضی، خانه سایت سریع است ولی گزارش مدیریتی کند شده است؛ تغییر تنظیم کش صفحه خانه مسئله گزارش را توضیح نمیدهد. نمودار همان عملیات را با نسخه برنامه، حجم داده و ساعت رخداد مقایسه کنید و اطلاعات حساس کاربر را وارد برچسبهای پایش نکنید.
۳. خطا را نسبت به حجم درخواست بسنجید
تعداد خام خطا بدون حجم ترافیک تصویر کاملی نمیدهد. ده خطا در تعداد بسیار کم درخواست با همان تعداد خطا در ترافیک گسترده تفاوت دارد. در کنار نسبت، نوع عملیات و اهمیت آن را ببینید؛ شکست یک عملیات حساس ممکن است حتی با سهم عددی کم نیازمند رسیدگی باشد. کدهای HTTP و خطاهای منطقی برنامه هم باید از هم قابل تشخیص باشند.
زمان خطا را با تغییرات اخیر تطبیق دهید. در تشخیص مشکلات وب، راهنمای کدهای HTTP و راهنمای خطای 503 کمک میکنند لایه بعدی بررسی را انتخاب کنید. هشدار باید نشانی داشبورد، بازه زمانی و سرنخ قابل استفاده داشته باشد، نه فقط عبارت کلی «سایت مشکل دارد».
۴. منابع را با روند و اثر بر سرویس تفسیر کنید
جهش کوتاه CPU هنگام یک کار برنامهریزیشده با فشار پایدار همراه افزایش زمان پاسخ یکسان نیست. حافظه مصرفشده نیز در سیستمعامل میتواند شامل کش قابل استفاده مجدد باشد؛ تنها از روی درصد کلی نتیجه نگیرید. فرآیندها، صف کار و رفتار واقعی برنامه باید بررسی شوند. برای مسیر تشخیص، مقاله مصرف بالای CPU در VPS جزئیات مرتبط را دارد.
دیسک را فقط با درصد مصرف نبینید. مقدار آزاد، inode و رشد داده تعیین میکنند چقدر زمان برای رسیدگی دارید. در مثال فرضی، سروری با فضای آزاد زیاد اما تولید داده بسیار سریع ممکن است زودتر از سرور کوچک با مصرف ثابت به مشکل برسد. اعلان ظرفیت باید فرصت اقدام بدهد و مالک داده یا سرویس مسئول را مشخص کند.
۵. اعتبار SSL و دامنه را پیش از اختلال دنبال کنید
برای دامنههای اصلی و زیردامنههای ضروری، مسئول تمدید و دسترسی به حساب ثبتکننده را مشخص کنید. تمدید خودکار را هم نیازمند کنترل نتیجه بدانید؛ تغییر روش پرداخت، پیام تمدید یا نقص نصب گواهی میتواند مسیر را متوقف کند. تست باید گواهی ارائهشده برای نام واقعی دامنه را ببیند، نه صرفاً وجود یک فایل روی سرور.
فاصله هشدارها را با زمان لازم تیم برای تمدید و رفع مشکل هماهنگ کنید. در سامانه دارای چند لایه پراکسی، گواهی عمومی و ارتباط امن تا مبدأ ممکن است جدا باشند. باید مشخص باشد کدام لایه پایش میشود و پیام برای مسئول همان بخش میرود. هیچ کلید خصوصی یا گذرواژهای نباید داخل گزارش عمومی قرار گیرد.
۶. برای هر هشدار، تصمیم و مسئول داشته باشید
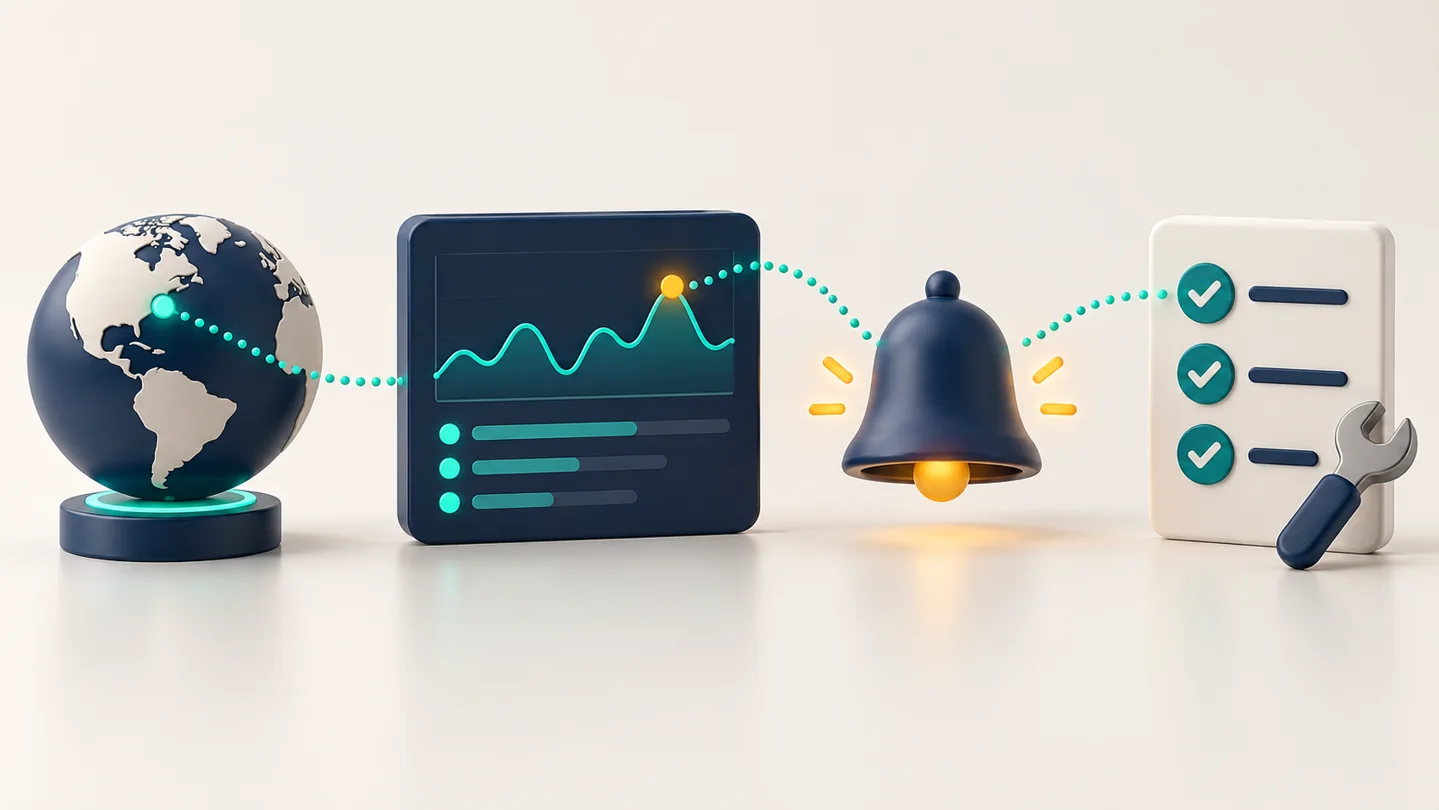
طبق راهنمای طراحی هشدار Prometheus، هشدار باید به مسئلهای قابل رسیدگی مربوط باشد. برای شروع، پیامها را بر اساس فوریت جدا کنید: اختلال فعال مسیر اصلی، خطر نزدیک نیازمند بررسی و روندی که در گزارش دورهای دنبال میشود. این تقسیم باید با توان واقعی تیم همخوان باشد.
یک الگوی پیام قابل استفاده چنین اجزایی دارد: نام سرویس، نشانه، بازه رخداد، اثر احتمالی، پیوند گزارش و اولین بررسی پیشنهادی. مشخص کنید اگر مسئول نخست پاسخ نداد، اطلاعرسانی به چه کسی منتقل شود. آستانه و مدت تداوم را پس از دیدن مصرف عادی تنظیم کنید؛ اعداد آزمایشی را بدون ارزیابی روی همه سرورها کپی نکنید.
ابزارهایی مانند Alertmanager امکان گروهبندی، مسیریابی و مدیریت سکوت هشدارها را فراهم میکنند. هدف این است که یک رخداد وابسته، دهها اعلان تکراری تولید نکند. در زمان نگهداری نیز سکوت باید دامنه و پایان مشخص داشته باشد؛ فراموش شدن سکوت نامحدود میتواند اختلال بعدی را پنهان کند.
۷. سلامت بکاپ و خود سامانه پایش را آزمایش کنید
پیام موفق بودن یک کار بکاپ، اثبات بازیابی نیست. تازگی آخرین نسخه، نتیجه اجرا، فضای مقصد و آزمون دورهای بازیابی را کنار هم ثبت کنید. برای طراحی مقصد، راهنمای بکاپ خارج از VPS را بخوانید. بهتر است برای شکست یا دیرکرد کار، مسیری وجود داشته باشد که وابسته به همان سرور معیوب نباشد.
جمعآوری داده نیز ممکن است قطع شود. نبود نمونه تازه، نمودار ثابت و قطع مسیر اعلان را با «همهچیز سالم است» اشتباه نگیرید. یک آزمون کنترلشده هشدار انجام دهید: آیا شرط درست تشخیص داده شد، پیام به فرد درست رسید و رفع مسئله هم اعلام شد؟ این آزمایش نباید با ایجاد اختلال واقعی برای کاربران انجام شود.
پرسشهای رایج درباره مانیتورینگ سرور
آیا Ping برای پایش سایت کافی است؟
خیر؛ پاسخ شبکه، موفق بودن وبسایت یا مسیر خرید را نشان نمیدهد. آزمون HTTP، محتوای مورد انتظار و در صورت نیاز عملیات آزمایشی را متناسب با پروژه تعریف کنید.
چند هشدار برای شروع مناسب است؟
تعداد ثابت مهم نیست؛ از موارد ضروری با مسئول و راهنمای اقدام روشن شروع کنید. هشداری که هیچ اقدام مشخصی ندارد، پیش از اضافه شدن به کانال فوری باید بازطراحی شود.
آیا نصب ابزار یعنی مدیریت کامل سرور؟
خیر؛ جمعآوری داده، تحلیل، دریافت هشدار و اجرای اصلاح مسئولیتهای جدا هستند. محدوده خدمات و زمان پاسخ باید از قبل مشخص شود.
از داشبورد به رسیدگی منظم برسید
برای شروع مانیتورینگ سرور، مسیرهای اصلی کاربر، چند شاخص قابل تفسیر و مسئول پیگیری را مشخص کنید. سپس هشدارها را با رخدادهای واقعی بازبینی کنید و نتیجه هر اصلاح را ثبت کنید. برای طراحی پایش و نگهداری متناسب با سایت، خدمات مدیریت سایت و سرور آفاق هاست را بررسی کنید و موضوع پایش، دوره بررسی و مسیر اعلام مشکل را در توافق روشن کنید.
سرویسهای مرتبط با این مطلب
برای بررسی راهکار مناسب، مشخصات و شرایط این خدمات را ببینید.
پرسشها و دیدگاههای شما
سؤال یا تجربه مرتبط با این مطلب دارید؟ با ما و خوانندگان مجله آفاق هاست در میان بگذارید.